200が返っても、llms.txt があるとは限りません
S&P 500の調査では、110社が /llms.txt で成功応答を返しました。実ファイルを返したのは71社だけです。ステータスコードがチェッカーをどう欺くのか、代わりに何を検証すべきかを説明します。
- llms.txt
- S&P 500
- AI可視性
- GEO
- 独自調査
110サイトがイエスと答え、本気だったのは71サイトでした
S&P 500の500社すべてのコーポレートサイトに対して /llms.txt をリクエストしました。
そのうち110社が2xxのステータスコードで応答しました。ステータス行だけを見るチェッカーなら、この応答はすべて合格します。
110件のうち実際のテキストファイルだったのは71件です。残りの39件は、200をまとった別の何かでした。
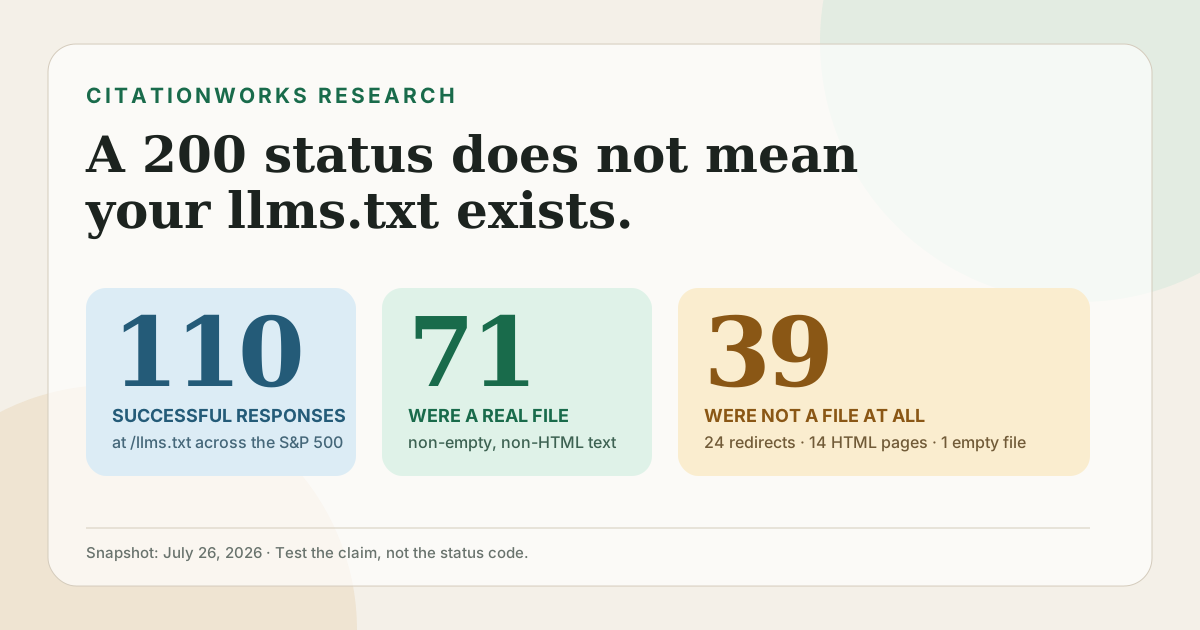
無料のAI対応チェックツールに自社ドメインを貼り付けて緑のチェックが出た経験があるなら、覚えておきたいのはこの数字です。
200は配達証明であり、ファイルではありません
HTTP 200は、サーバーが応答を返したという意味です。その応答があなたの求めたものかどうかについては、何も語りません。
39件の誤検出は、5つのパターンに分かれました。
- 24件はパスから離れてリダイレクトしました。/llms.txt へのリクエストはまったく別の場所に着地し、その着地ページが200を返しました。Procter & Gambleは /404/ に、Palantirは /404 に、Exelonはエラー用パスに、Textronは /access-denied に、UnitedHealth Groupは page-not-found.html に、Hasbroは日本語ロケールの販売店ページに着地しました。いずれも200を返しています。
- 7件は、そのパスのまま汎用のHTMLフォールバックを返しました。URLは動いていません。本文は、そのサイトが未知のURLすべてに返すページでした。対照リクエストで確認済みです。FedEx、Charles Schwab、Fifth Third Bancorp、EOG Resources、Church & Dwight、W. W. Grainger、Ulta Beautyがここに該当します。Ultaの応答は15バイトで、中身は「Be Right Back.」だけでした。
- 4件は、そのパスで汎用フォールバックとは別のHTMLを返しました。Ametek、Evergy、Flex、Live Nation Entertainmentです。別のページではありますが、テキストファイルではありません。
- 3件は、見つからないと自ら書いてあるHTMLページを返しました。Carnival、Lumentum、Syscoです。成功に見せかけたソフト404です。
- 1件は、中身のない本物のテキストファイルを返しました。Sherwin-Williamsは text/plain、200、0バイトでした。
共通点に注目してください。誰も意図的に間違ったことをしていません。llms.txt が登場する何年も前に設定されたとおりに、ごく普通のウェブ基盤が動いているだけです。
だからこそ、チェッカーはステータスコードを信用できません。ステータスコードはもともと、あなたのファイルについて語るものではないのです。
一方で、リダイレクトそのものも何も証明しません
リダイレクトをすべて失敗と決めてしまえば話は簡単です。データがそれを許しません。
実ファイル71件のうち24件も、リクエストしたURLとは違うURLに着地しています。その多くは退屈で正しい種類のものでした。httpからhttpsへ、あるいはwwwなしのドメインからwwwへの移動です。Archer Daniels Midland、Nucor、Paychex、Leidosはいずれもリダイレクトし、いずれも本物のファイルを返しました。
覚えておく価値があるのはArthur J. Gallagherの例です。本物のファイルは末尾スラッシュ付きの /llms.txt にあり、51,165バイトの正当なMarkdownでした。最初のパスではソフト404と判定しましたが、誤りでした。
問うべきは、そのリダイレクトがファイルに着くのかマーケティングサイトに着くのかであり、リダイレクトしたかどうかではありません。
顧客を失わせるのは、逆向きの誤りのほうです
誤検出はきまりが悪い程度で済みます。見落としのほうが深刻です。企業に対して、自社サイトについての事実でないことを伝えてしまうからです。
500サイトのうち94サイトからは、信頼できる答えが得られませんでした。アクセス拒否64件、ネットワーク障害27件、繰り返し発生したサーバーエラー3件です。このうち1件たりとも不在には数えていません。「アクセス不能」として数えました。これは私たちの測定についての記述であり、相手のサイトについての記述ではありません。
この区別は役に立ちました。直接のHTTPパスでは67件を検出しました。ヘッドレスChromeによる2回目のパスで、1回目が切り捨てていた4件が見つかりました。
- T-Mobileは直接のリクエストを403で遮断しました。ブラウザでは、タイトルとリンクを備えた22,368バイトのファイルが見つかりました。
- Essex Property Trustは429でレート制限をかけてきました。ブラウザでは、タイトルとリンクを備えた8,144バイトのファイルが見つかりました。
- Arthur J. Gallagherは、ある地点からはソフト404に見え、別の地点からは51,165バイトのファイルでした。
- Norfolk Southernはスクレイパーに空の応答を返しました。ブラウザではファイルを取得できました。長さは1バイトです。
71件のうち4件、見つけたファイル全体の5.6%は、まともなスクレイパーでも最初の一回では見えませんでした。WAFが拒否した瞬間に「不在」と報告するモニタリングツールは、推測をデータと呼んでいます。
解決策は対照であり、より賢い推測ではありません
曖昧なケースを解決した方法を紹介します。追加のリクエストは1回だけです。
/llms.txt が成功ステータスでHTMLを返してきたら、同じオリジンに、存在しえないパスもリクエストします。同じホスト、同じ拡張子で、ランダムな名前のものです。そして2つの応答を比べます。
最終URLが同じ、正規化した本文が同じ、あるいはタイトルが同じでサイズもほぼ同じなら、それはサイト共通のフォールバックであり、あなたのファイルはそこにありません。応答が違うなら、そのパスには何か固有のものが配信されており、詳しく見る価値があります。
これが、ステータスコードを読むことと、主張を検証することの違いです。陰性対照は「サーバーが200と言った」を「このパスは、偽物とわかっているパスとは違う挙動をする」に変えます。
追加リクエスト1回で、パスが動かないままHTMLを返し、しかもエラーとは名乗らなかった11件すべてに決着がつきました。7件はサイト共通のフォールバックでした。4件はそのパスにある別の何かで、やはりファイルではありませんでした。
自社のファイルを5分で確認する
- ヘッダーを表示しながら、リダイレクトを追ってファイルをリクエストします。curlなら curl -sSL -D - -o /dev/null https://yourdomain.com/llms.txt です。最後のステータスだけでなく、最終URLを読みます。
- コンテンツタイプを見ます。今回の調査では、本物のファイル64件が text/plain、7件が text/markdown で配信されていました。text/html になっているなら、配信しているのはウェブページであり、ファイルではありません。
- 本文の先頭200バイトを見ます。doctype、ナビゲーションバー、「page not found」の文字が見えたら、それが答えです。
- 同じホストに、/this-does-not-exist-9f2a.txt のような偽のパスをリクエストします。llms.txt の応答と似ていたら、その llms.txt の応答は本物ではありません。
- サイズを確認します。今回観測した範囲は1バイトから1メガバイト超までです。1バイトのファイルは存在確認を通りますが、誰の役にも立ちません。メガバイト級のダンプは、このファイルが解こうとした問題をそのまま再現します。
- 社内ネットワークの外、そしてCDNの主要リージョンの外から、同じ確認を繰り返します。500サイトのうち64サイトが私たちのアクセスを拒否しました。その大半の企業は、自社ページが公開されていて誰でも到達できると考えているはずです。
どれもツールを必要としません。そしてどれも、ほとんどのツールが省略している作業です。
チェッカーが本当に記録すべきこと
この調査をきっかけに、自分たちの考え方を組み立て直しました。ファイルチェックが出すべきものは証拠であり、判定ではありません。
- リクエストしたURLと最終URLを、分けて記録する。
- コンテンツタイプと、本文がHTMLに見えるかどうか。
- 応答のサイズと、途中で切り詰めたかどうか。
- 同じオリジンのランダムな対照パスが、同じものを返したかどうか。
- 測定方法。直接取得とブラウザ取得は別の実験だからです。
- 状態を平易な言葉で。実ファイル、そのパスにあるHTMLページ、別の場所へのリダイレクト、不在の確認、測定不能。状態は5つであり、2つではありません。
ファイル自体についても、正直に書いておきます。llms.txt の提案が求めるのはH1です。ファイル一覧のセクションは任意なので、Markdownリンクは必須ではありません。私たちがファイルを「非標準」と呼ぶとき、それは自分たちのより厳しい品質基準に届かなかったという意味であり、仕様に違反しているという意味ではありません。検出した71件のうち17件がこの基準に届かず、そのうち14件は理由がひとつだけでした。H1はあるが、リンクが1本もないというものです。
別の2件は逆のパターンです。SalesforceとU.S. Bancorpは、リンクだらけで1メガバイト近いファイルを公開していますが、先頭にH1がありません。サイズはキュレーションではありません。17件目はNorfolk Southernの1バイトのファイルで、技術的には存在していますが誰の役にも立ちません。
存在は配管にすぎません
ここまでの話は、ファイルを正しく測ることについてであり、そのファイルが事業を変えるという主張ではありません。
llms.txt を公開することで、AIアシスタントがあなたに言及する、引用する、正確に説明するようになるという証拠は、私たちの手元にはありません。Googleは検索がこれを無視すると述べており、生成AI機能についても同じです。提案そのものが約束しているのは整理された地図であり、ランキングへの効果ではありません。
安く作れて役に立つなら、きれいなファイルを公開してください。重要なページはクロールでき、理解できる状態に保ってください。そのうえで、実際に売上につながるものを測ります。購買者が尋ねたときに、アシスタントがブランドに言及するか、事実を正しく伝えるか、自社ページを引用するかです。
ステータスコードに付いた緑のチェックは、この分野で最も簡単に偽装できる数字です。AI可視性の取り組みをその上に組み立てないでください。
調査方法
スナップショットは2026年7月26日に完了しました。対象は500社で、複数の株式クラスをまとめる前は503のS&P 500銘柄にあたります。各社のコーポレートルートサイトに対し、リダイレクト追従つきで /llms.txt をリクエストし、判定が曖昧なケースと失敗したケースはヘッドレスChromeで再試行しました。
確認した500サイトの内訳は、2xxが110件、404が295件、410が1件、403が64件、繰り返しの5xxが3件、応答なしが27件です。検出と数えたのは、成功応答で本文が空でもHTMLでもなく、サイトのランダム対照パスと同じ挙動をしなかった場合だけです。その結果、検出71件、不在確認330件、アクセス不能94件、同一パスでのHTML応答4件、空ファイル1件となりました。
これは公開ファイルを対象にした、ある時点での技術的な全数調査です。ウェブサイト、セキュリティ設定、インデックスの構成はいずれも変わります。貴社について誤りがあればご連絡ください。訂正します。
注記
- 39件の誤検出の内訳は、パスから離れたリダイレクト24件、同一パスでの汎用HTMLフォールバック7件、同一パスでのその他のHTML応答4件、自ら404と名乗るHTMLページ3件、空のテキストファイル1件です。
- アクセスできなかった94サイトを不在に数えることはありません。私たちの収集環境からは、実際の llms.txt の状態を観測できませんでした。
- llms.txt の提案はH1を必須とし、ファイル一覧のセクションは任意としています。H1とリンクを求める私たちの基準は独自のより厳しい品質基準であり、仕様適合のテストではありません。
- 本調査のいかなる内容も、llms.txt を公開することでAIの回答にブランドが登場する、順位付けされる、引用されるようになることを示すものではありません。